
VoiceStudio, le clone gratuit d’ElevenLabs : l’installer, t’en servir et ce que la licence permet
L’appli open source qui clone une voix, double une vidéo et lit un livre sur ton ordinateur : ce qu’elle fait face à ElevenLabs, la machine qu’il faut, l’installation pas à pas, le moteur à prendre pour le français, la licence et la loi. Dépôt relu le 10 novembre 2026 : on n’a pas installé l’appli.
Eigenflow · mis à jour le
VoiceStudio, son installation pas à pas, le moteur à choisir pour le français et ce que la licence te permet, vérifiés le 10 novembre.
Télécharger le PDF ↓L'essentiel en 30 secondes
- L’appli est gratuite, mais le modèle de voix installé par défaut, OmniVoice, est sous licence non commerciale. Pour une pub, un client ou la voix de ta boîte, prends un autre moteur (partie 11) et lis la partie 12.
- Il te faut un Mac à puce Apple sous macOS 13.3 ou plus récent, un PC sous Windows 10 ou 11, ou un Linux x64. Sur un Mac Intel, l’interface s’ouvre mais les modèles ne tournent pas.
- Prévois environ 10 Go de disque et 8 Go de mémoire pour démarrer. Une carte graphique accélère tout, elle n’est pas obligatoire.
- Internet sert au début, pour télécharger les modèles (3,3 Go pour celui par défaut). Après, tout se passe sur ta machine.
- Clone ta propre voix, ou celle de quelqu’un qui t’a dit oui. En France, diffuser en ligne la voix générée d’une personne sans son accord, et sans dire que c’est de l’IA, peut coûter deux ans de prison et 45 000 €.
- Au 10 novembre, la version stable est la v0.5.7, sortie le 26 octobre 2026. Une bêta (v0.5.8) est sortie le 9 novembre.
Partie 1Ce que c’est, et ce que ça ne fait pas
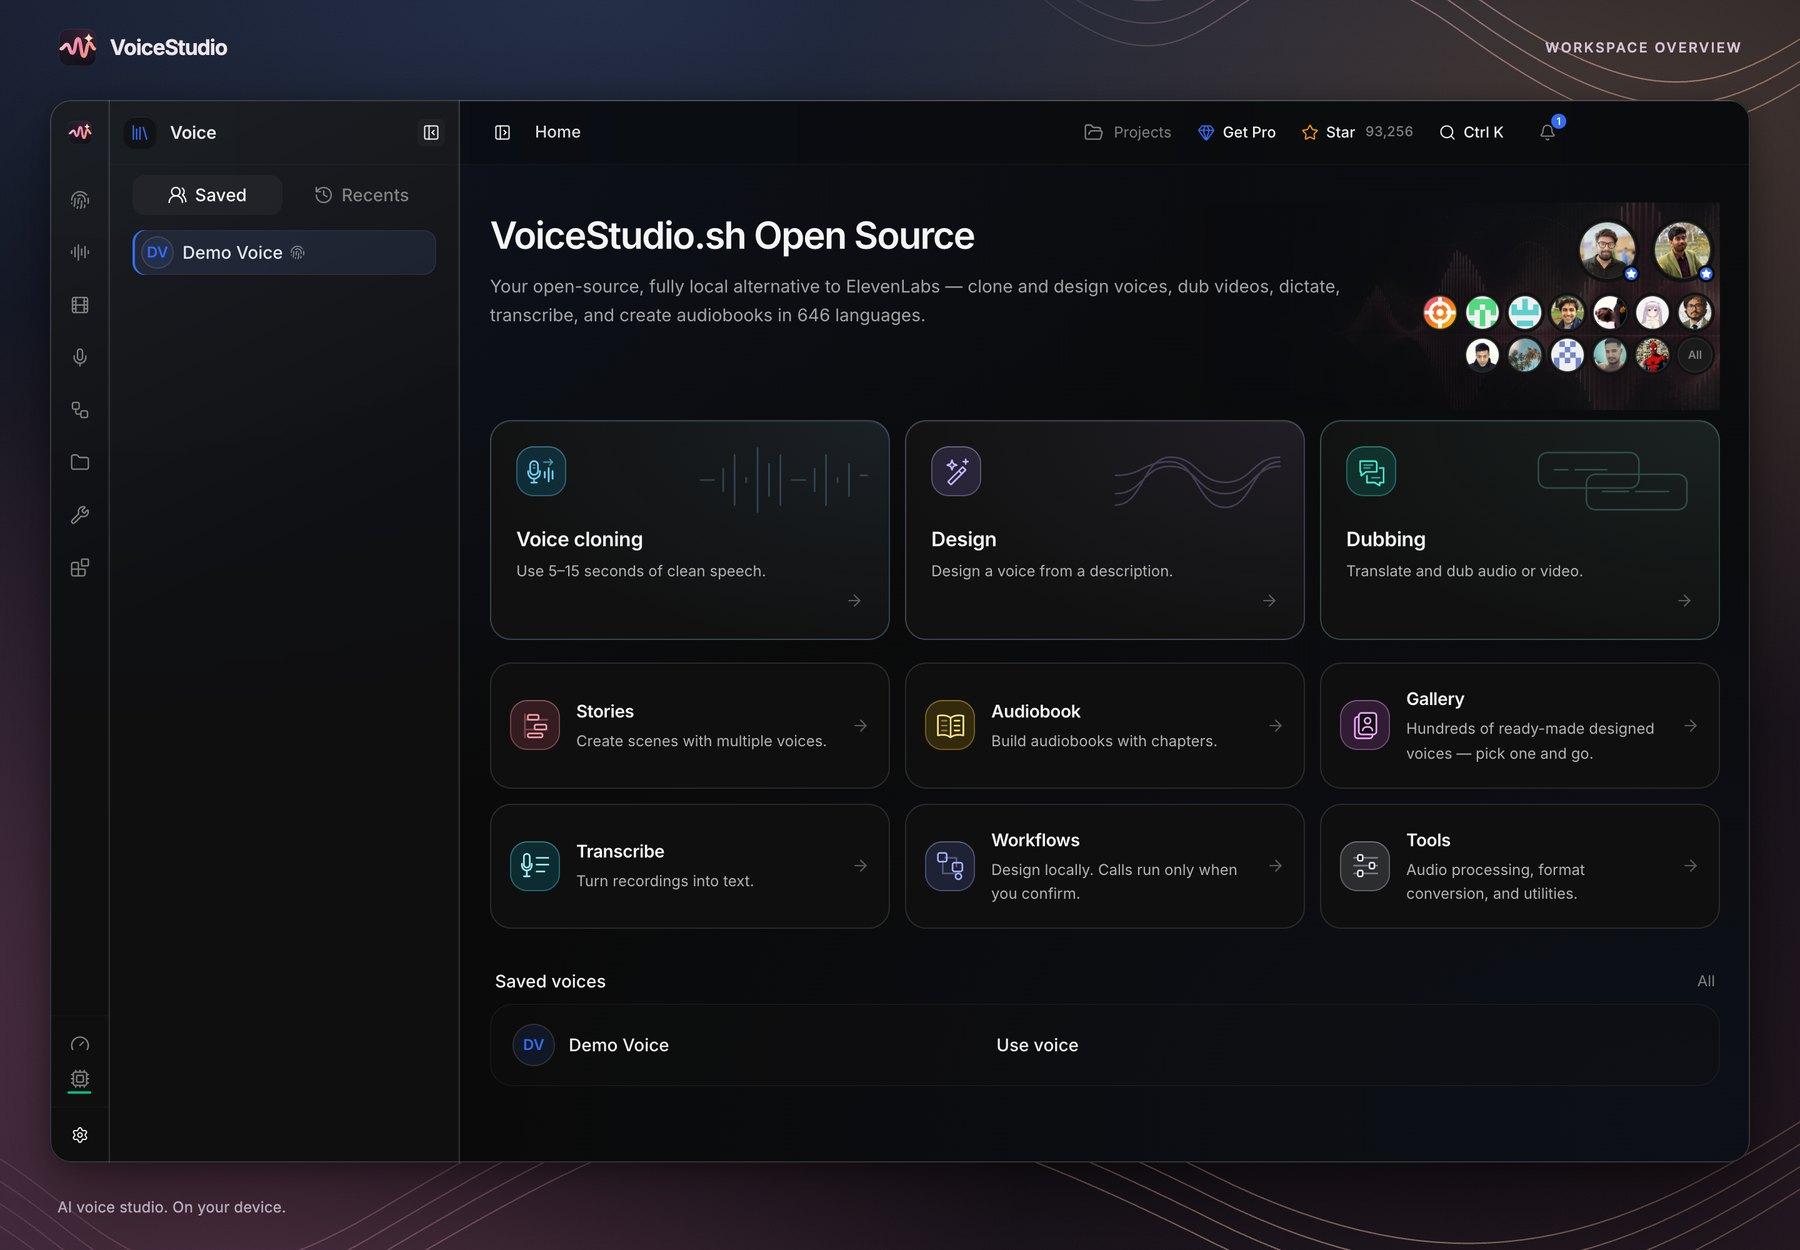
Sur GitHub, VoiceStudio se décrit comme « the open-source, fully-local ElevenLabs alternative » (l’alternative à ElevenLabs, open source et entièrement locale). Le dépôt a été créé le 9 avril 2026 par Palash Debnath, un développeur d’Agartala, dans le nord-est de l’Inde. Au relevé du 10 novembre, il affiche 106 915 étoiles et 11 856 forks.
Le « dev tout seul » de la vidéo vaut pour les quatre premiers mois. Jusqu’au 9 août, Palash signe 1 195 des 1 277 commits. Et sur ses commits de cette période, 74 % portent la mention « Co-Authored-By: Claude » : il a codé en binôme avec un agent de code. Depuis le 10 août, un second développeur, Shimul Debnath, a rejoint l’équipe principale (1 080 commits à ce jour), et 157 personnes ont contribué en tout. Une société indienne, Yupcha Softwares, maintient le projet.
Les modèles de voix viennent d’ailleurs. OmniVoice, le moteur par défaut, a été entraîné par l’équipe chinoise k2-fsa, et VoiceStudio en rassemble une vingtaine dans une seule appli. Pour un projet de sept mois, la liste qui suit impressionne quand même.
Ce que l’appli fait :
- cloner une voix à partir de quelques secondes d’enregistrement ;
- concevoir une voix à partir d’une description, sans enregistrement ;
- doubler une vidéo ou un audio dans une autre langue ;
- lire un texte long ou un livre, chapitre par chapitre, avec plusieurs voix ;
- transcrire, dicter, isoler une voix du bruit de fond, faire parler un audio avec une autre voix ;
- prêter sa voix à tes propres outils, par une API locale compatible OpenAI et un serveur MCP.
Il lui manque plusieurs choses qu’ElevenLabs vend : la génération de musique, l’image et la vidéo, une plateforme d’agents vocaux clés en main, une bibliothèque où ta voix est payée quand d’autres s’en servent, et un service en ligne (VoiceStudio Cloud est annoncé, pas ouvert). Les effets sonores sont arrivés dans le code le 10 novembre. Ils ne sont dans aucune version téléchargeable à cette date et demandent une carte NVIDIA.
Partie 2VoiceStudio ou ElevenLabs, en chiffres
ElevenLabs, relevé le 10 novembre 2026 sur sa page de tarifs en français, en dollars hors taxes :
- Gratuit : 0 $, 10 000 crédits par mois, environ 10 minutes de voix. Pas de clonage, pas d’usage commercial.
- Starter : 6 $ par mois (1 $ le premier mois jusqu’au 16 novembre), 30 000 crédits, environ 30 minutes. Clonage instantané et usage commercial.
- Créateurs : 22 $ par mois (11 $ le premier mois), 121 000 crédits, environ 121 minutes, un clone « professionnel ».
- Pro : 99 $ par mois, 600 000 crédits, environ 600 minutes.
La page le précise : « Les tarifs s’entendent hors taxes ». Sur le site, une génération plafonne à 10 000 caractères avec Eleven v4 et à 5 000 avec les autres modèles. ElevenLabs annonce « plus de 90 langues ».
VoiceStudio, le même jour : 0 $, ni crédits ni compte. Pas de quota de caractères non plus, puisqu’un texte long est coupé aux fins de phrases puis recollé. La vraie limite, c’est le temps de calcul : par défaut, une génération s’arrête au bout de 5 minutes de calcul sur carte graphique et de 10 sur processeur, un peu plus pour un texte long, et ce budget se règle. Le site annonce 646 langues, celles du modèle OmniVoice.
Toutes ces langues ne se valent pas. Le tableau du dépôt donne les heures d’enregistrement qui ont servi à l’entraînement : 23 675 heures pour le français, mais 12 heures ou moins pour 465 des 646 langues. Pour le français, l’anglais, l’allemand ou l’espagnol, aucun souci. Pour une langue rare, écoute avant de publier.
Le point qui pèse le plus pour une entreprise touche aux droits. Chez ElevenLabs, l’abonnement payant inclut le droit d’utiliser la voix commercialement, dès Starter. Chez VoiceStudio, l’appli est libre mais chaque modèle garde sa licence, et celle du modèle par défaut interdit l’usage commercial (partie 12).
Partie 3La machine qu’il te faut
D’après la documentation du dépôt au 10 novembre 2026 :
- Mac : macOS 13.3 (Ventura) ou plus récent, sur puce Apple. PyTorch n’est plus publié pour les Mac Intel, donc les modèles ne s’y installent pas. L’interface peut seulement se brancher sur un VoiceStudio installé sur un autre ordinateur.
- Windows : 10 ou 11 en 64 bits. Une carte NVIDIA accélère le calcul. Sans elle, tout tourne sur le processeur, plus lentement. La version pour puces ARM (Snapdragon X) est expérimentale.
- Linux : x64 avec un bureau graphique. Pas de version ARM.
- Disque : environ 10 Go pour l’appli, son environnement Python et les modèles. Environ 5 Go sur un PC Windows sans carte NVIDIA.
- Mémoire : « About 8 GB of RAM is enough to start » (8 Go de mémoire suffisent pour démarrer), dit le site.
- Carte graphique : pour le modèle par défaut, la doc recommande au moins 6 Go de mémoire vidéo. Sur une carte de 4 Go, un rendu de quelques secondes peut durer des minutes. Sur une petite machine, prends un moteur léger (partie 11).
Python, FFmpeg et les modèles s’installent seuls au premier lancement, et l’appli te demande avant chaque téléchargement de modèle. Un compte Hugging Face (gratuit) ne sert que pour certains modèles et pour séparer plusieurs voix dans un doublage.
Partie 4Installer sur Mac
Le README propose trois chemins. Le plus simple passe par Homebrew :
brew tap debpalash/tap
brew trust --cask debpalash/tap/voicestudio
brew install --cask debpalash/tap/voicestudio
Sans Homebrew, télécharge le DMG sur la page des versions. Prends le fichier « mac-arm64 » pour un Mac à puce Apple (267 Mo pour la v0.5.7), ouvre-le et glisse VoiceStudio dans Applications. Le fichier « mac-x64 » sert aux Mac Intel, avec la limite vue plus haut.
Troisième chemin, l’installeur en une commande. Il choisit le bon DMG, vérifie sa somme de contrôle et installe l’appli :
curl -fsSL https://voicestudio.sh/install | sh
Cette commande exécute un script téléchargé. Si tu ne lances jamais un script sans l’avoir lu, ouvre d’abord voicestudio.sh/install dans ton navigateur, ou prends le DMG.
Le message « VoiceStudio est endommagé »
macOS peut afficher « VoiceStudio is damaged and can’t be opened ». Le message vient de Gatekeeper, le contrôle d’Apple : il bloque une appli téléchargée quand elle n’a ni signature Developer ID ni notarisation par Apple. Ton fichier est intact, et la doc du projet reconnaît elle-même que le mot « endommagé » est trompeur. D’après les notes de version, les DMG de la v0.5.7 sont signés et notarisés. Ce message concerne donc surtout les anciennes versions et les compilations maison.
S’il s’affiche quand même, vérifie d’abord le fichier, puis compare le résultat avec le fichier SHA256SUMS.txt de la même version :
shasum -a 256 ~/Downloads/VoiceStudio*.dmg
Si les deux valeurs sont identiques, ton téléchargement est bon. Retire alors l’attribut de quarantaine, une fois par installation :
xattr -dr com.apple.quarantine "/Applications/VoiceStudio.app"
Pour le message plus doux, « le développeur ne peut pas être vérifié », pas besoin du terminal : clic droit sur l’appli, Ouvrir, puis Ouvrir dans la fenêtre. Sur macOS 15 Sequoia, double-clique une fois, va dans Réglages Système, Confidentialité et sécurité, puis clique sur « Ouvrir quand même ».
Partie 5Installer sur Windows
Télécharge VoiceStudio-0.5.7-win-x64.exe (211 Mo) sur la page des versions et lance-le. Il s’installe pour ton compte, sans droits d’administrateur. Tu peux aussi passer par un PowerShell normal :
irm https://voicestudio.sh/install.ps1 | iex
L’installeur Windows n’est pas signé, les notes de la v0.5.7 le disent elles-mêmes. SmartScreen affiche donc « Windows a protégé votre ordinateur » : clique sur « Informations complémentaires », puis sur « Exécuter quand même ». Au premier lancement, l’appli cherche une carte NVIDIA. Si elle n’en trouve pas, elle télécharge la version processeur de PyTorch, plus légère.
Chaque moteur en plus peut peser plusieurs gigas. Pour les ranger ailleurs que sur C:, la doc donne cette commande PowerShell, à lancer avant d’ouvrir VoiceStudio (change le chemin) :
[Environment]::SetEnvironmentVariable('OMNIVOICE_ENGINES_DIR', 'D:\VoiceStudio\engines', 'User')Partie 6Installer sur Linux
L’AppImage (255 Mo) marche sur toutes les distributions. Télécharge-la sur la page des versions, puis :
chmod +x VoiceStudio-*-linux-x64.AppImage
./VoiceStudio-*-linux-x64.AppImage
Sur Ubuntu, Debian ou Mint, avec le paquet .deb téléchargé dans le dossier courant :
sudo apt install ./VoiceStudio-*-linux-x64.deb
Avec Snap, la seconde ligne donne l’accès au micro :
sudo snap install voicestudio
sudo snap connect voicestudio:audio-record
Sur Arch, c’est yay -S voicestudio-bin. L’installeur en une commande de la partie 4 marche aussi sous Linux, et il sait désinstaller l’appli en gardant tes voix et tes projets :
curl -fsSL https://voicestudio.sh/install | sh -s -- --uninstall
Partie 7Cloner ta voix
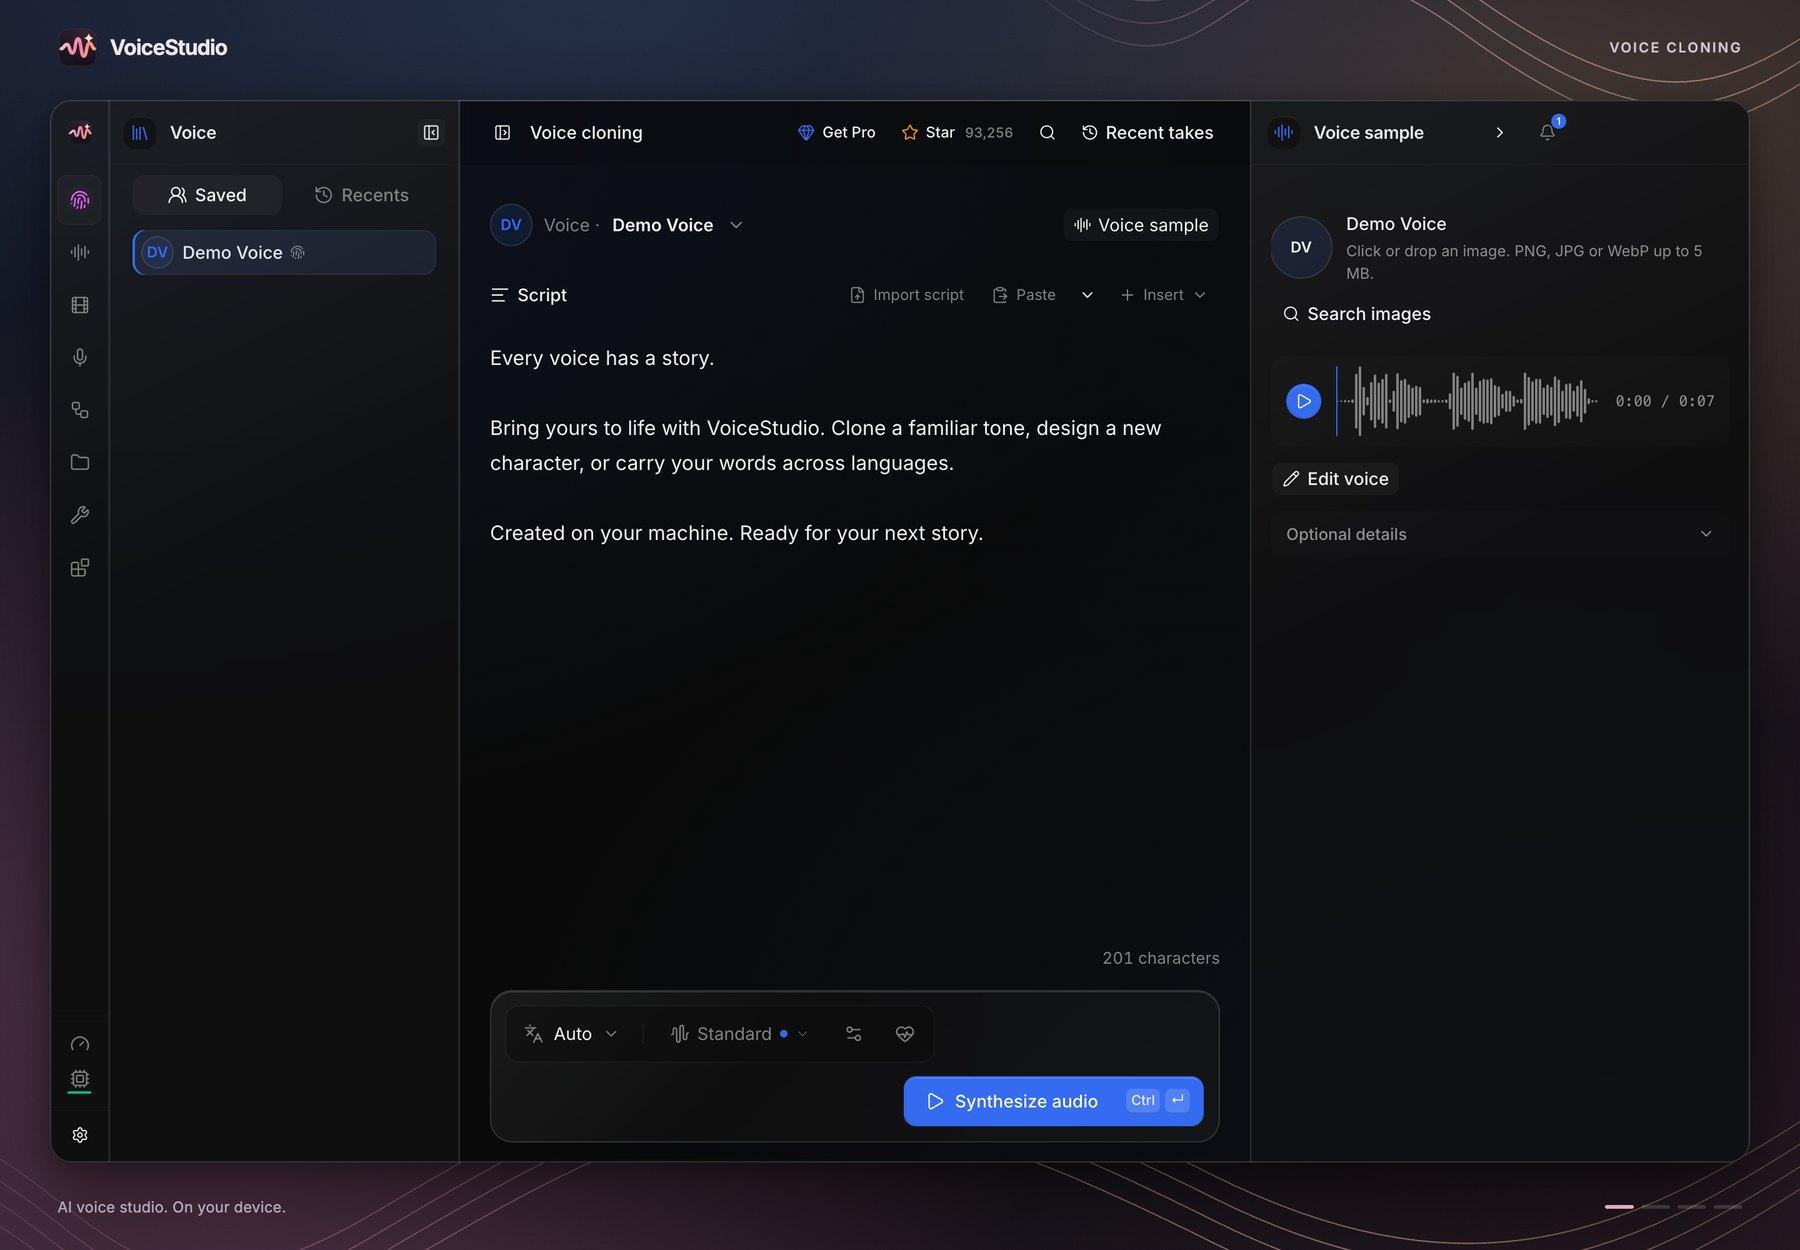
Le README tient en une ligne : ouvre Voice cloning, choisis une voix ou ajoute un enregistrement de référence propre, tape ton texte et génère.
Avant de pouvoir t’en servir, l’appli te fait accepter la licence du modèle par défaut, une seule fois, dans Model Catalogue. Lis-la, c’est là qu’est écrit « non commercial ».
La qualité du clone se joue sur l’enregistrement de référence :
- La durée. L’écran d’accueil demande 5 à 15 secondes de parole propre (« clean speech »). Les auteurs d’OmniVoice conseillent plutôt 3 à 10 secondes, parce qu’un audio plus long ralentit le calcul et peut dégrader le clone. L’appli accepte jusqu’à 75 secondes, mais OmniVoice n’en garde que les 15 où l’on parle le plus.
- La langue. Enregistre-toi dans la langue que la voix devra parler. Le README d’OmniVoice prévient qu’une référence dans une autre langue laisse son accent dans la voix générée.
- Le son. Une pièce calme, pas de musique, une seule personne, le micro près de la bouche. Dis une phrase naturelle plutôt qu’une liste de mots.
- Le texte. Tape mot pour mot ce que tu dis dans l’extrait. La doc d’OmniVoice indique que la transcription améliore le clone. Si tu la laisses vide, l’appli la fait elle-même quand un modèle de transcription est installé.
Ensuite, écris ton texte, choisis la langue et clique sur Synthesize audio. Sous chaque prise, « Check audio » repère les silences trop longs, la saturation ou un fichier vide, sans rien modifier. À l’export, tu choisis un WAV 16 bits (le plus léger, 2,9 Mo par minute), 24 bits pour le montage ou 32 bits flottants.
Partie 8Concevoir une voix sans enregistrement
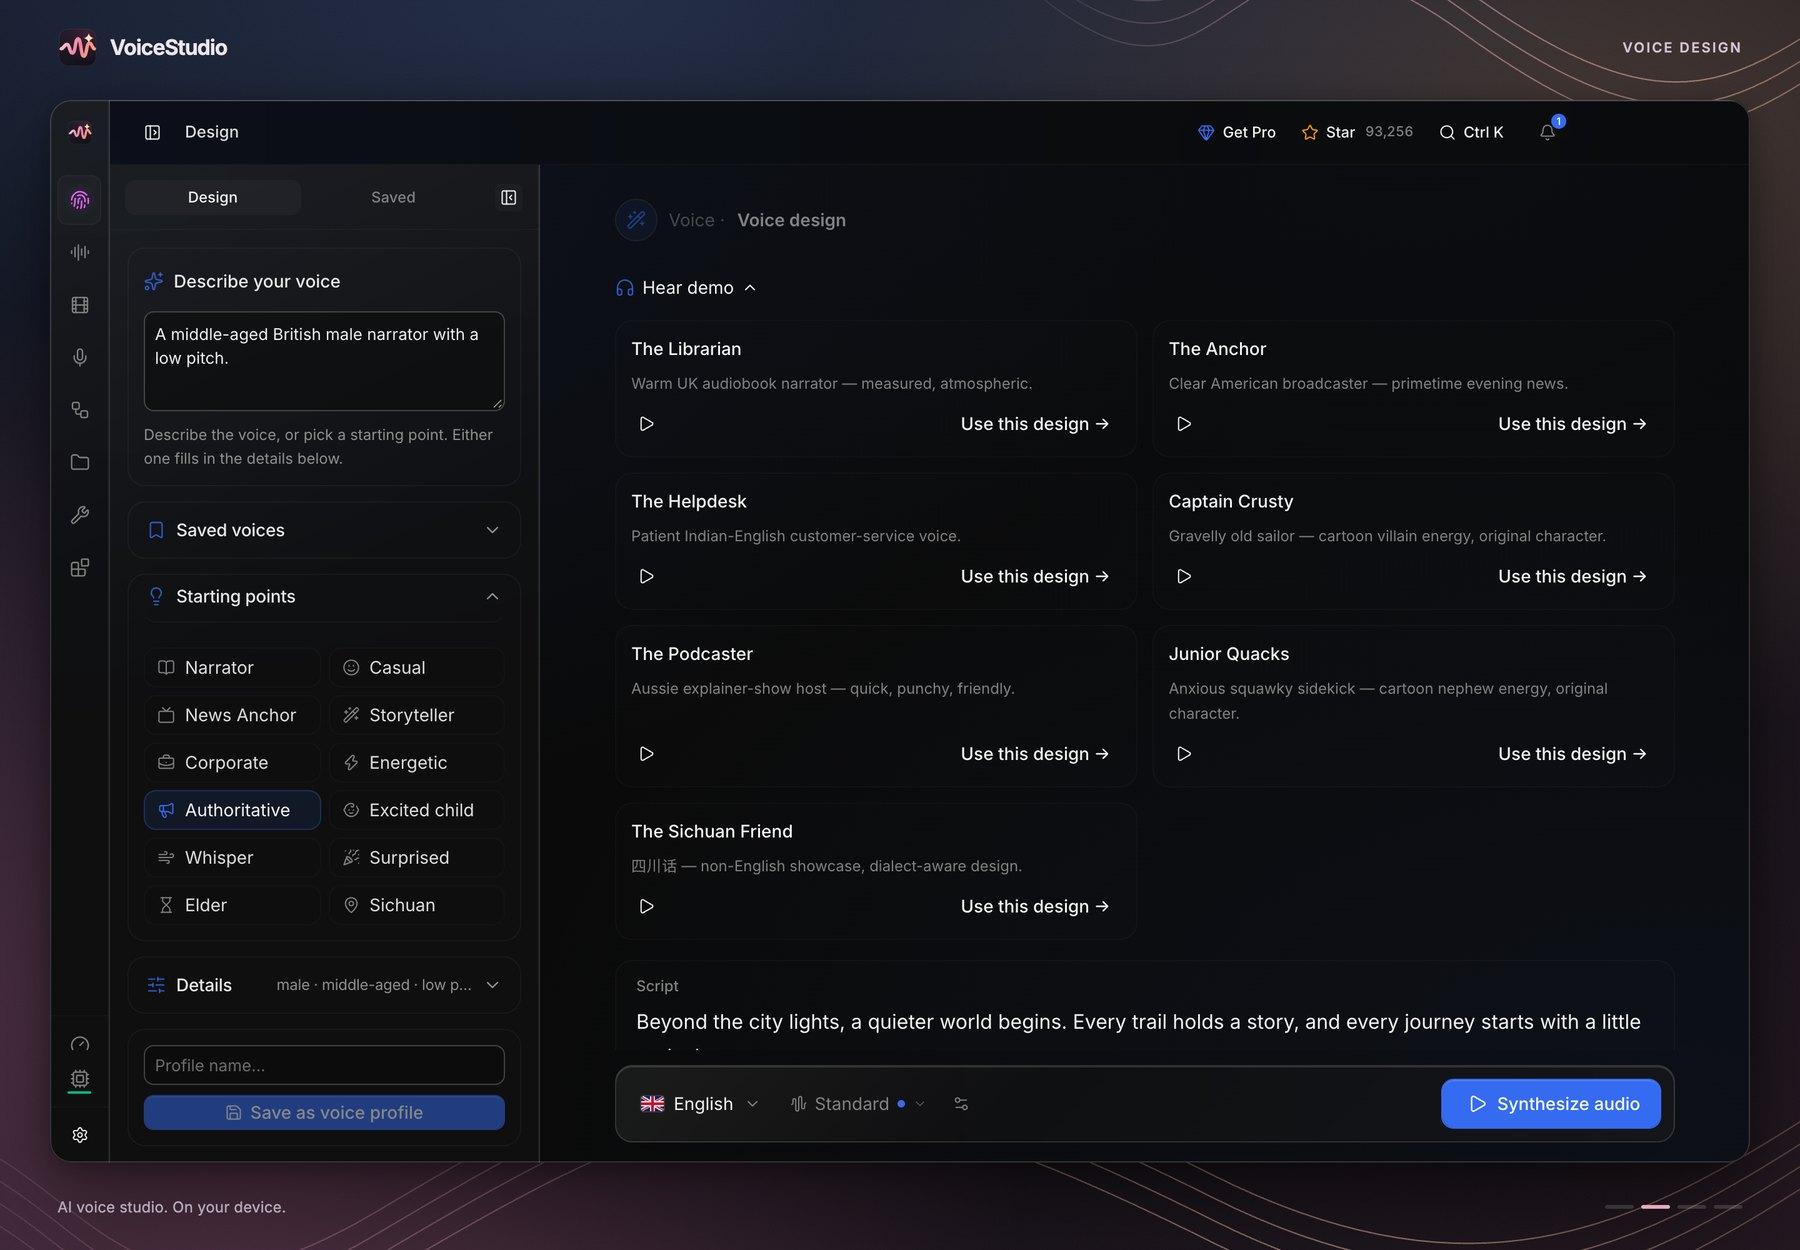
Dans Design, décris la voix en une phrase ou pars d’un point de départ (Narrator, News Anchor, Corporate, Whisper…). Les réglages se remplissent : genre, âge, hauteur, style. Écris un texte, génère, puis clique sur « Save as voice profile » pour la garder.
Avec OmniVoice, la description est ramenée à une liste fixe d’attributs, et tout ce qui sort de cette liste est ignoré. Les accents proposés sont des accents anglais. La doc ajoute que le design a été entraîné en anglais et en chinois : en français, fais plusieurs essais avant d’en faire la voix de tes contenus. Pour une description libre, elle conseille VoxCPM2.
Partie 9Doubler une vidéo
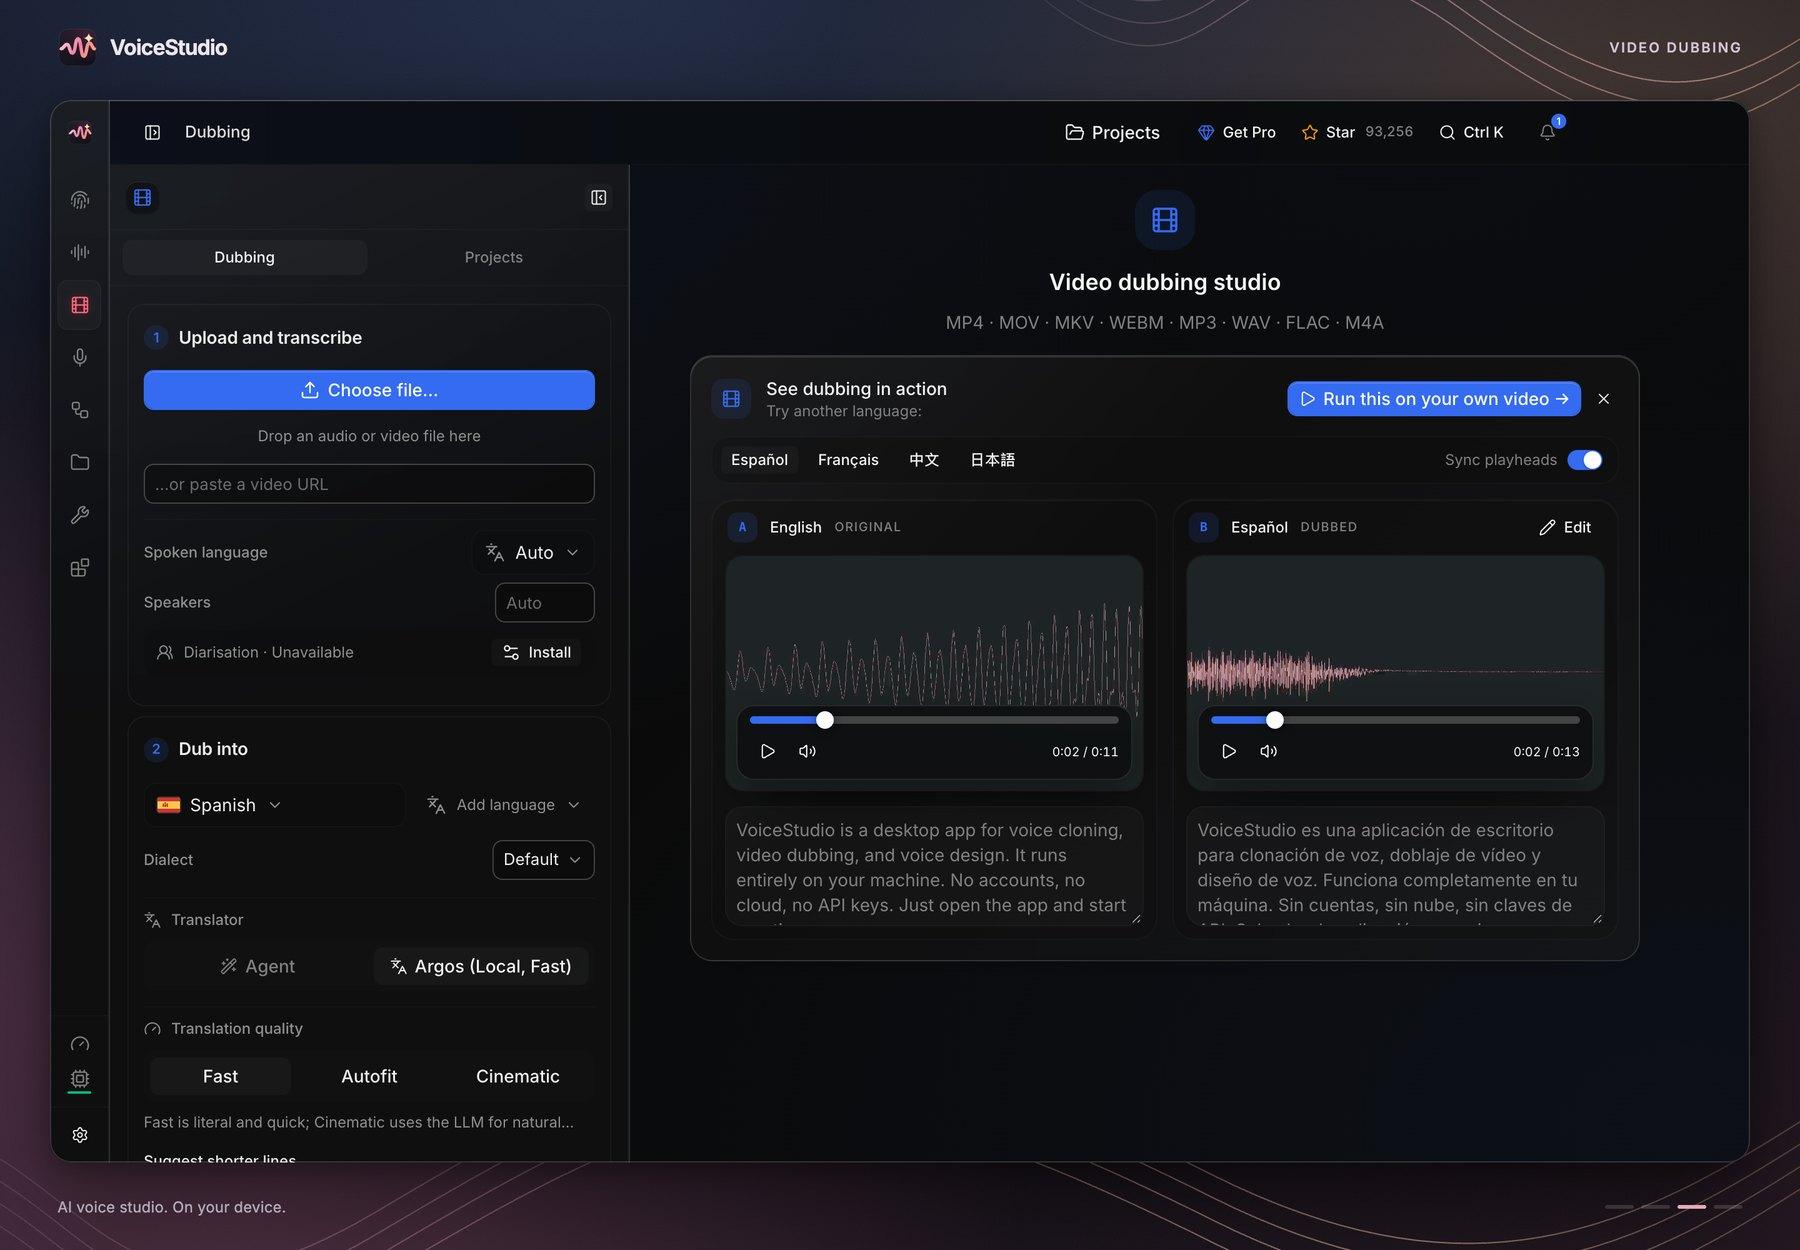
L’appli enchaîne trois étapes : elle transcrit, traduit, puis fait parler la voix.
- Dans Dubbing, dépose ta vidéo ou ton audio (MP4, MOV, MKV, WEBM, MP3, WAV, FLAC, M4A) ou colle un lien. Laisse la langue parlée sur Auto.
- Dans « Dub into », choisis la langue d’arrivée. Tu peux en ajouter plusieurs.
- Choisis le traducteur, relis chaque ligne traduite, puis génère et exporte (audio en WAV ou MP3, sous-titres incrustés si tu veux).
Deux traducteurs sont intégrés et tournent sans Internet, une fois la paire de langues téléchargée : Argos, rapide, et NLLB-200, plus lourd et meilleur, qui couvre 200 langues. La fiche de NLLB-200 le présente comme un modèle de recherche, sous licence non commerciale. En ligne, tu as Google Translate, DeepL et Microsoft (ces deux-là avec une clé), ou un modèle de langage branché avec ta clé. Les modes Autofit et Cinematic, qui reformulent chaque phrase pour qu’elle tienne dans le temps de l’original, ont besoin de ce modèle de langage.
Pour un usage pro, le plus sûr reste « Paste Translation » : tu traduis de ton côté, avec l’outil ou la personne de ton choix, et tu colles le texte. Les timings sont gardés.
S’il y a plusieurs personnes qui parlent, l’appli a besoin d’un modèle Hugging Face en accès restreint pour séparer les voix : crée un compte gratuit et accepte ses conditions.
Partie 10Faire un livre audio
Deux pages s’en chargent. Audiobook prend un livre : importe un TXT, un Markdown, un EPUB ou un PDF, et l’appli repère les chapitres. Stories sert aux histoires à plusieurs voix : tu donnes une voix à chaque personnage, ligne par ligne.
Dans le texte, quelques balises : [pause 0.5s] pour une pause, [voice:NOM] pour changer de voix, [emotion:...] pour l’émotion avec les moteurs qui la gèrent. L’export sort en MP3 ou en M4B, le format des livres audio qui garde les chapitres. Un préréglage règle le volume aux normes d’ACX, la plateforme de production d’Audible. Si le rendu s’arrête en route, tu le reprends où il en était.
Personne ne chiffre le temps qu’il faut pour un livre entier sur un portable. Avant de lancer 300 pages, rends un chapitre et regarde la vitesse que l’appli affiche.
Partie 11Quel moteur pour le français
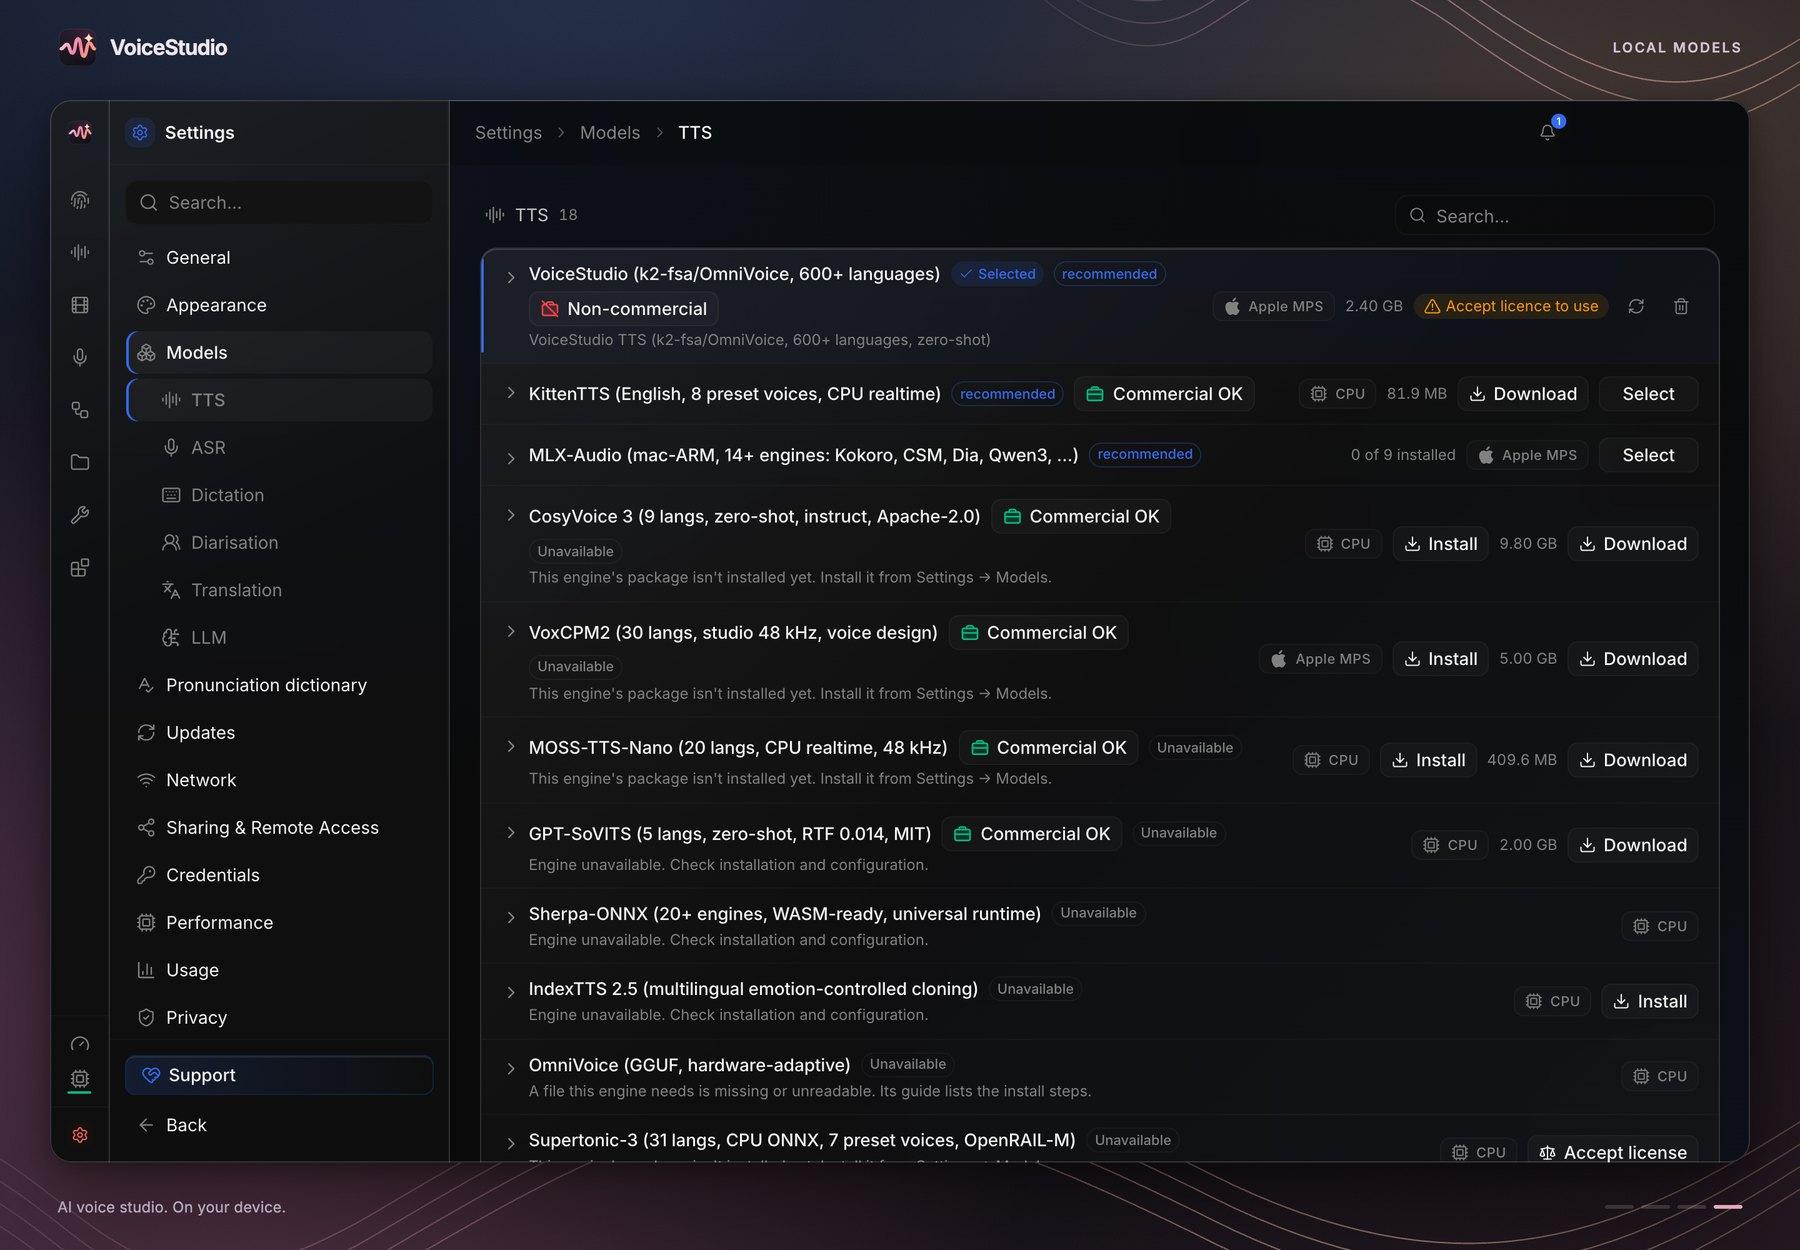
La version stable compte 18 moteurs de synthèse, et le code du 10 novembre en a 20. Plusieurs sont des variantes du même modèle, et un seul est installé d’office. Voici ceux qui parlent français d’après leur documentation, avec la licence affichée par l’appli ou par la fiche du modèle :
- OmniVoice, le moteur par défaut : clonage, design, 646 langues. Poids sous licence non commerciale (CC-BY-NC).
- VoxCPM2 : 30 langues dont le français, clonage, design par description libre, son en 48 kHz. Licence Apache-2.0, et sa fiche dit « free for commercial use ». Il s’installe en un clic dans Model Catalogue (5 Go).
- CosyVoice 3 : 9 langues dont le français, clonage. Apache-2.0, 9,8 Go.
- PocketTTS, de Kyutai : 6 langues dont le français, clonage, rapide sur un simple processeur. Poids en CC-BY-4.0, derrière un accès Hugging Face.
- MOSS-TTS-Nano : 20 langues dont le français, temps réel sur processeur, 410 Mo. L’appli affiche Apache-2.0, mais la fiche du modèle demande de le traiter comme non licencié pour la redistribution tant que son fichier de licence n’est pas publié. Vérifie avant un usage pro.
- Confucius4-TTS (14 langues) parle aussi français, mais s’installe en ligne de commande. Ming-3.0-tts (7 langues) aussi, avec une carte NVIDIA, et il n’est que dans le code, pas encore dans la version stable.
KittenTTS ne parle qu’anglais. GPT-SoVITS, IndexTTS 2.5 et Breeze-TTS-2 ne gèrent pas le français.
En pratique, prends OmniVoice pour tester et pour tes projets perso, VoxCPM2 dès que la voix sert ton activité. Sur un ordinateur sans carte graphique, essaie PocketTTS.
Partie 12La licence, avant tout usage pro
Il y a deux licences à lire : celle de l’appli et celle du modèle.
L’appli est sous AGPL-3.0. Tu peux t’en servir gratuitement, y compris dans ton entreprise. Si tu la modifies et que d’autres l’utilisent par le réseau, tu dois leur fournir le code source de ta version. Pour l’intégrer à un produit fermé sans cette obligation, il faut la licence commerciale de VoiceStudio Pro.
Pro coûte 99 $ par utilisateur et par an, ou 199 $ en une fois. Ce sont les prix de lancement affichés le 10 novembre. Il apporte la licence commerciale du code, l’usage sur trois appareils, l’envoi de calculs vers tes autres cartes graphiques et les nouveautés en avance, avec un remboursement possible sous 7 jours. C’est une version fermée, qui demande un compte et envoie des données de licence et d’usage.
Chaque modèle garde sa propre licence. Le site de VoiceStudio l’écrit noir sur blanc : acheter Pro ne change pas les conditions des modèles, et « the OmniVoice pretrained model is noncommercial » (le modèle pré-entraîné OmniVoice est non commercial). Ses auteurs l’expliquent par les données qui ont servi à l’entraîner. NLLB-200, le gros traducteur hors ligne, est lui aussi non commercial.
Pour une voix off client, une pub ou une formation que tu vends, choisis donc un moteur sous licence permissive (VoxCPM2, CosyVoice 3), traduis toi-même ou avec un service dont tu as les droits, et garde une trace de la licence acceptée. L’appli enregistre la date et le texte exact de chaque licence de modèle que tu acceptes.
Partie 13Le cadre légal en France
Textes relus le 10 novembre 2026.
- L’article 226-8 du Code pénal, modifié par la loi SREN du 21 mai 2024, punit d’un an de prison et de 15 000 € d’amende la diffusion, sans le consentement de la personne, d’un « contenu visuel ou sonore généré par un traitement algorithmique et représentant l’image ou les paroles d’une personne », quand rien n’indique clairement qu’il est généré. En ligne, la peine monte à deux ans et 45 000 €. Les contenus sexuels relèvent de l’article 226-8-1, plus sévère, et prévenir que c’est de l’IA n’y change rien.
- La voix est protégée comme l’image. La Cour de cassation l’a écrit le 24 juin 2026 (1re chambre civile, n° 25-20.483) : « A l’instar de son image, la voix d’une personne est l’un des attributs principaux de sa personnalité. »
- Au sens du RGPD, la voix est une donnée personnelle. Elle devient une donnée biométrique protégée par l’article 9 quand elle sert à identifier quelqu’un. La CNIL rappelle que si ta voix est utilisée sans ton accord, tu peux porter plainte auprès d’elle.
- L’article 50 de l’AI Act s’applique depuis le 2 août 2026. Il oblige celui qui diffuse un hypertrucage dans un cadre professionnel, par exemple un audio généré qui imite une personne réelle et peut passer pour vrai, à dire qu’il a été généré par une IA. D’après la FAQ de la Commission européenne, un usage purement personnel n’est pas concerné. Dès que l’activité te rapporte de façon régulière, tu l’es.
- Le dépôt de VoiceStudio pose la même règle : « Clone a voice only with its owner’s permission » (ne clone une voix qu’avec l’accord de son propriétaire). Par défaut, VoiceStudio glisse aussi un filigrane inaudible (AudioSeal) dans ce qu’il génère quand ce module est disponible. Le réglage est dans Settings, Privacy.
Clone ta voix, ou celle d’une personne qui t’a donné son accord par écrit, et dis-le quand une voix est générée. Pas de voix de célébrité, pas de collègue « pour rire ».
Partie 14Les limites, honnêtement
- Le projet est jeune, publié en avril 2026, et change chaque jour. La version stable est la v0.5.7. Les bêtas sont pour ceux qui acceptent les bugs.
- La qualité dépend du moteur et de la langue. Une langue peu présente dans les données d’entraînement sonnera moins bien.
- Une référence enregistrée dans une autre langue donne un accent à la voix. Enregistre-toi dans la langue d’arrivée.
- Sur une carte graphique de 4 Go, le moteur par défaut peut mettre des minutes là où il devrait mettre des secondes. La doc conseille alors OmniVoice GGUF ou un moteur fait pour le processeur.
- Plusieurs moteurs en plus s’installent en ligne de commande, et certains ne tournent que sur une carte NVIDIA.
- L’appli gratuite ne se connecte que quand tu le demandes, pour une mise à jour ou un modèle. Les statistiques d’usage ne partent que si tu les acceptes.
- On n’a rien installé : tout ce guide vient du dépôt, de ses captures et des pages officielles.
Les sourcesSources
- Le dépôt VoiceStudio sur GitHub : README, guides d’installation macOS, Windows et Linux, guides des moteurs, docs/audio-quality.md, docs/dubbing/translation-engines.md, docs/electron-longform.md, docs/languages.md, LICENSE-NOTICE.md et historique des commits, relus le 10 novembre 2026.
- Les notes de la version v0.5.7, 26 octobre 2026.
- voicestudio.sh et la page Pro, relus le 10 novembre 2026.
- La fiche du modèle OmniVoice et le README d’OmniVoice.
- La fiche de NLLB-200 et celle de VoxCPM2.
- Les tarifs d’ElevenLabs et la liste de ses modèles, relus le 10 novembre 2026.
- L’article 226-8 du Code pénal, la loi n° 2024-449 du 21 mai 2024 et l’arrêt de la Cour de cassation du 24 juin 2026.
- Le RGPD, l’AI Act, la FAQ de la Commission sur l’article 50 et la page de la CNIL sur les hypertrucages.
Fondateur d’Eigenflow. On construit des agents et des automatisations IA pour les PME et les indépendants.
Guide écrit le 10 novembre 2026 sans installer VoiceStudio : README, documentation et code de la branche main et de la version v0.5.7, notes de version, historique des 7 452 commits lu par l’API GitHub, site voicestudio.sh et fiches Hugging Face des modèles. Prix d’ElevenLabs relevés le même jour sur sa page en français, en dollars hors taxes. Textes de loi relus sur Légifrance et EUR-Lex. Les captures d’écran sont celles que l’équipe de VoiceStudio publie dans son dépôt (29 octobre 2026). La voix du reel vient de la synthèse vocale de Gemini, pas de VoiceStudio.
Une voix IA pour ton entreprise, dans les règles ?
On choisit avec toi le moteur, la licence et la façon de t’en servir, puis on l’installe dans ton activité.
Le guideCe qu’il y a dans ce guide
Tu as commenté VOIX, voici le guide. VoiceStudio est une appli gratuite et open source qui clone une voix, en invente une, double une vidéo et lit un livre entier, sur ton ordinateur et sans compte. Tu trouveras ici ce qu’elle fait vraiment, comment l’installer, par où commencer et ce que tu as le droit d’en faire.
On a tout relu le 10 novembre 2026 : le dépôt GitHub, sa documentation, ses notes de version, le site voicestudio.sh, les pages d’ElevenLabs, et les textes de loi sur Légifrance et EUR-Lex. On n’a pas installé VoiceStudio : les captures d’écran sont celles que l’équipe publie dans son dépôt. Et la voix de la vidéo a été faite avec la synthèse vocale de Gemini, chez Google : VoiceStudio n’y a pas servi.
Le projet change tous les jours, avec 977 commits entre le 1er et le 10 novembre. Si un chiffre a bougé le jour où tu lis, crois la documentation du dépôt.
On n’a aucun lien avec VoiceStudio ni avec ElevenLabs. Aucun lien de ce guide ne nous rapporte quoi que ce soit.